
Im privaten Chat spielt es für das eigene Abo kaum eine Rolle, was ein einzelner Screenshot kostet. Im Unternehmenseinsatz sieht das jedoch völlig anders aus: Wenn Mitarbeitende im Arbeitsalltag über eine zentrale KI-Plattform haufenweise Dokumente und Bildschirmfotos in Sprachmodelle (LLMs) hochladen, belastet das sowohl das Kontextfenster als auch das IT-Budget. Spätestens dann werden solche Anfragen zu einem echten Kostenfaktor für das Unternehmen – denn Teams arbeiten mit festen Kontingenten oder rechnen direkt nach API-Verbrauch (Pay-as-you-go) ab.
An unserer Enterprise-Lösung Einblickjetzt.de arbeiten nicht nur wir bei Finelbo, sondern auch die Kollegen von InnovaForge in enger Kollaboration zusammen: Gemeinsam implementieren und betreuen wir maßgeschneiderte Open-WebUI-Umgebungen für Unternehmen und verbinden diese mit unserer Beratung für Agentic Data Engineering. In unseren Gesprächen mit IT-Leitern und Architekten taucht dabei immer wieder eine zentrale Frage auf: „Wie hoch ist eigentlich der tatsächliche Token-Verbrauch – und welche API-Kosten entstehen uns in Open WebUI, wenn unsere Teams Screenshots oder Dokumente an verschiedene angebundene KI-Modelle senden?“
Um das praxisnah zu zeigen, nehmen wir einen typischen Test-Screenshot mit 1920×1080 Pixeln und berechnen das Volumen des visuellen Inputs nach den offiziellen Entwicklerregeln für GPT 6.1-sol, Claude Opus 5.5 und Gemini 3.1 Pro Preview. Alle drei Modelle lassen sich über Einblickjetzt.de nahtlos in Open WebUI einbinden und parallel nutzen. Gleichzeitig schauen wir uns an, was das KI-Modell nach dem Bildupload im Hintergrund tatsächlich erhält und warum eine hohe Auflösung allein noch keine Garantie dafür ist, dass kleine Schrift fehlerfrei gelesen wird.
Hinweis: Die Berechnungsformeln stammen aus den offiziellen Dokumentationen der jeweiligen Modellanbieter; die genannten Preise basieren auf den offiziellen API-Tarifen der Provider zum Zeitpunkt der Veröffentlichung (Oktober 2026, umgerechnet in Euro netto für Unternehmenskunden).
Das Wichtigste in Kürze
- Unterschiedliche Berechnungslogiken: Für denselben Full-HD-Screenshot (1920×1080 Pixel) veranschlagt GPT 6.1-sol 2.040 Tokens (32×32-Raster), Claude Opus 5.5 2.691 Tokens (28×28-Raster) und Gemini 3.1 Pro Preview bis zu 1.120 Tokens (im Modus
high).- Dateigröße vs. Pixelabmessung: Dateigröße (KB/MB) und Bildkomprimierung (JPEG vs. PNG) haben keinen Einfluss auf den Token-Verbrauch. Ausschlaggebend sind ausschließlich die Pixel-Abmessungen und das modellspezifische Raster.
- Zuschneiden viertelt den Verbrauch: Das gezielte Freistellen des relevanten Bereichs auf 960×540 Pixel reduziert den Token-Verbrauch bei GPT und Claude um rund 75 % (−74 % bis −75 %), während die Lesbarkeit kleiner Schriften zu 100 % erhalten bleibt.
- Budgetkontrolle in Open WebUI: Für den produktiven Unternehmenseinsatz mit Plattformen wie Open WebUI und Einblickjetzt.de sind vordefinierte Bildmodi und Token-Quotas unerlässlich, um Context Window Overflows und unerwartete API-Rechnungen zu vermeiden.
Was passiert nach dem Hochladen eines Bildes?
Die interne Architektur proprietärer KI-Modelle lässt sich von außen nur in Grundzügen nachvollziehen. Zwar veröffentlichen die Anbieter die Regeln für die Bildvorverarbeitung (Preprocessing) und die Token-Abrechnung, doch der exakte Aufbau jeder einzelnen Modellschicht bleibt unter Verschluss. Auf API-Ebene – also genau dort, wo Open WebUI mit den Modellen kommuniziert – läuft der Prozess in drei Schritten ab:
- Prüfung und Skalierung: Der Dienst prüft Dateiformat und Abmessungen des Bildes. Überschreitet die Datei bestimmte Grenzwerte, wird sie automatisch herunterskaliert oder abgewiesen.
- Umwandlung in visuellen Input: Das Bild wird in eine für das Modell lesbare Struktur zerlegt. Einige Modelle unterteilen das Bild in quadratische Segmente – sogenannte Patches oder Kacheln (Tiles) –, während andere dem Bild ein ungefähres Token-Budget zuweisen.
- Verarbeitung im Kontextfenster: Der visuelle Input gelangt zusammen mit dem Text-Prompt in den Kontext des Modells, woraufhin die KI ihre Textantwort generiert.
Vereinfacht dargestellt sieht die Verarbeitungskette so aus:
Pixel → Größenanpassung → Patches oder Kacheln (Tiles) → Numerische Repräsentationen → Antwort
Ein einzelner Patch ist allerdings noch kein fertiger Bedeutungsträger. Ein Fehlercode aus Buchstaben und Ziffern kann beispielsweise genau auf der Grenze mehrerer Quadrate liegen – sodass das Modell den Buchstaben im einen Patch und Teile der Ziffer im nächsten Patch erfasst. Das neuronale Netz setzt diese Fragmente anschließend in Beziehung zueinander und gleicht sie mit der Nutzeranfrage ab. Bittet man das Modell in Open WebUI darum, den Fehlercode auszulesen, lokalisiert es auf diese Weise den relevanten Bildschirmbereich.
Wird ein Bild jedoch im Vorfeld stark verkleinert, können kleine Buchstaben miteinander verschmelzen. Je mehr Patches das Modell erhält, desto höher ist die Wahrscheinlichkeit, dass feine Details erhalten bleiben. Dennoch empfehlen wir unseren Kunden im Rahmen von Data Governance & AI Privacy grundsätzlich, kritische Angaben wie Artikelnummern, Rechnungsbeträge oder Fehlercodes anhand des Originals gegenzuprüfen.
Drei Berechnungsmodelle im Vergleich: GPT, Claude und Gemini
Nehmen wir unseren Full-HD-Screenshot mit 1920×1080 Pixeln. Im ersten Schritt bewerten wir noch nicht, wie zuverlässig die Modelle eine Tabelle auslesen oder einen Fehler diagnostizieren. Wir berechnen ausschließlich den Umfang des visuellen Inputs gemäß der offiziellen Entwicklerdokumentation.
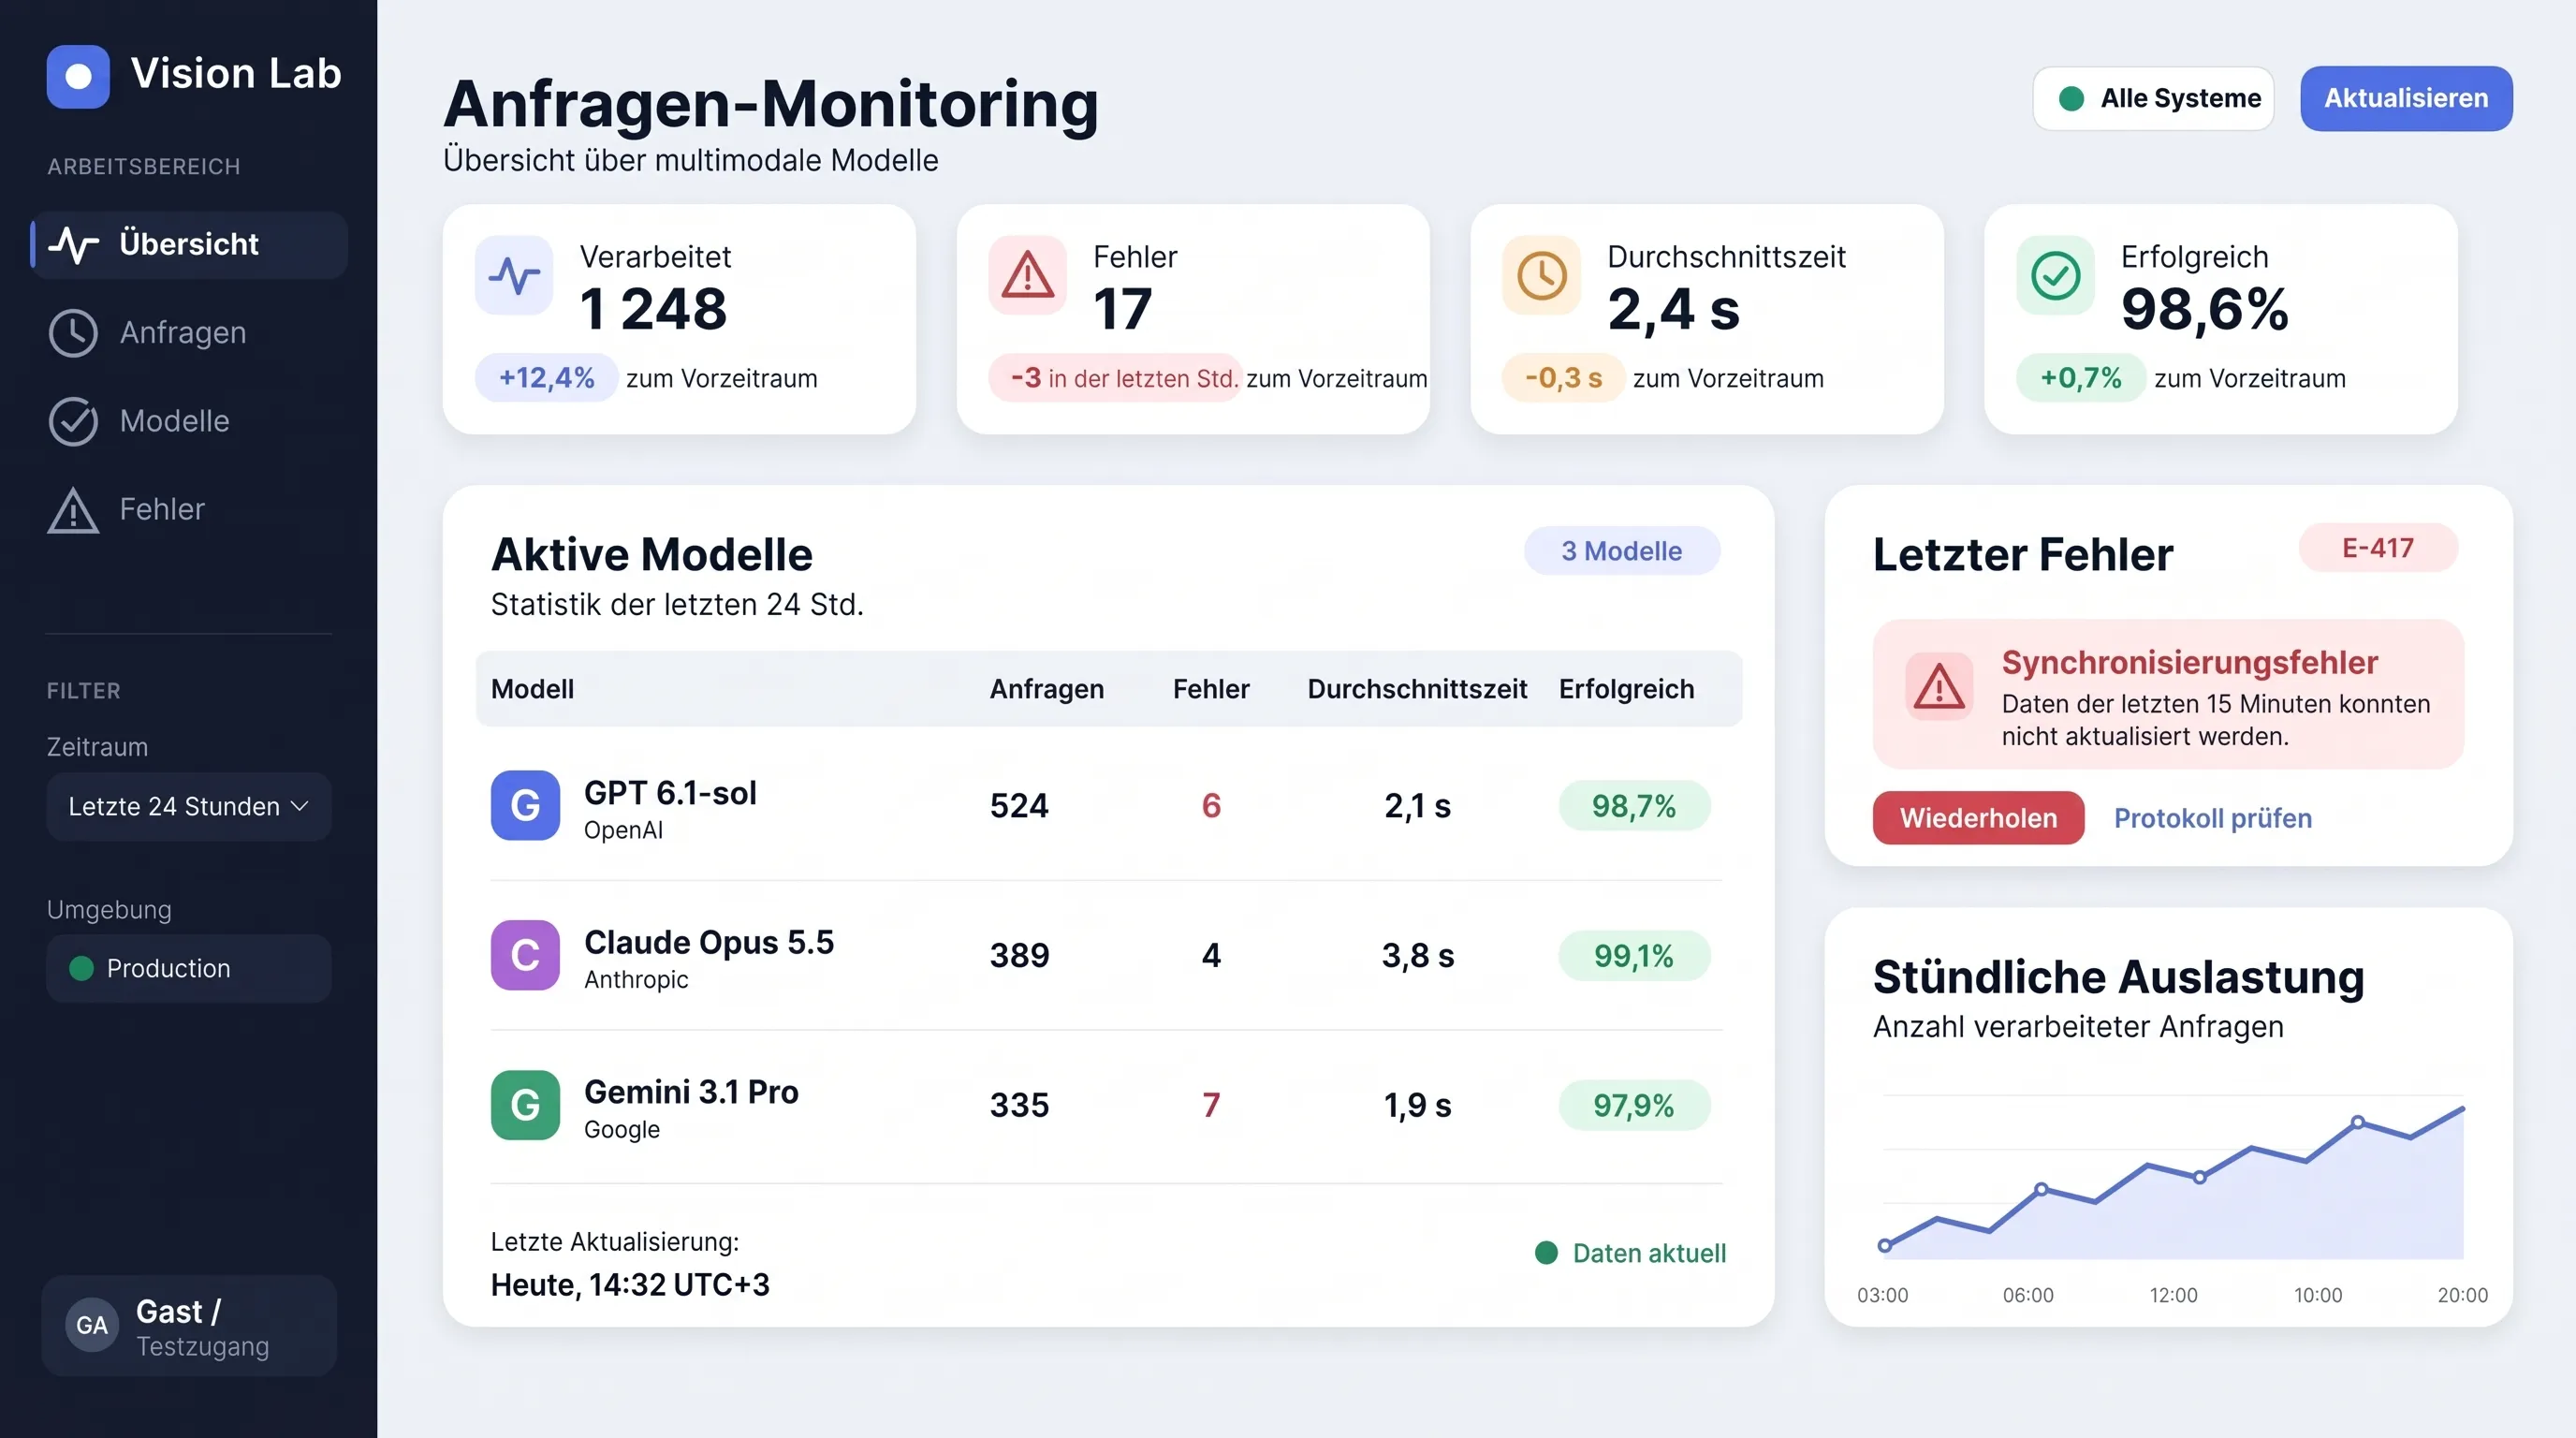 Test-Screenshot in nativer Full-HD-Auflösung (1920×1080 Pixel). Alle Daten sind fiktiv.
Schauen wir uns die Bildverarbeitung bei GPT 6.1-sol, Claude Opus 5.5 und Gemini 3.1 Pro Preview im Detail an. Alle drei Modelle wenden völlig unterschiedliche Berechnungslogiken an.
GPT 6.1-sol (OpenAI): 32×32-Raster
GPT 6.1-sol legt ein Raster aus 32×32 Pixel großen Quadraten über das Bild. Im Modus high sind bis zu 2.500 Patches sowie maximal 2.048 Pixel an der längeren Bildkante zulässig. Unser Screenshot hält beide Grenzwerte problemlos ein:
ceil(1920 / 32) × ceil(1080 / 32) = 60 × 34 = 2040
Das ergibt 2.040 visuelle Tokens. Wichtig dabei: Anschnitt-Patches an den Bildrändern werden immer als volle Einheiten gezählt, selbst wenn ein Teil des Quadrats über den eigentlichen Bildrand hinausragt. (Bei einem offiziellen OpenAI-API-Preis für GPT 6.1-sol von 2,00 $ bzw. ca. 1,78 € pro 1 Million Input-Tokens kostet der reine Bildupload dieses Screenshots über Open WebUI rund 0,0041 $, also ca. 0,0036 € bzw. rund 0,4 Cent.)
Im Modus low würde das Modell lediglich eine auf 512×512 Pixel reduzierte Version erhalten. Das spart zwar Tokens, führt aber fast immer dazu, dass kleine Beschriftungen unleserlich werden. Für OCR-Aufgaben (Texterkennung), kleine UI-Elemente und eine präzise Koordinatenbestimmung empfiehlt OpenAI den Modus original.
Zudem nutzt der Anbieter je nach Modellgeneration unterschiedliche Formeln. GPT‑4o verwendet beispielsweise ein anderes Schema: Dort wird das Bild skaliert und in 512×512 Pixel große Kacheln (Tiles) unterteilt, zu denen noch ein fixer Basiswert an Tokens addiert wird.
Claude Opus 5.5 (Anthropic): 28×28-Patches im High-Resolution-Tier
Claude unterteilt das Bild in kleinere Patches von 28×28 Pixeln. Anthropic ordnet die Modelle ab Claude 4.7 der Stufe mit erhöhter Auflösung (High-Resolution-Tier) zu. Unser Screenshot mit 1920×1080 Pixeln passt ohne Herunterskalierung in die Limits dieser Stufe:
ceil(1920 / 28) × ceil(1080 / 28) = 69 × 39 = 2691
Hier landen wir bei 2.691 visuellen Tokens. (Da Anthropic für Claude Opus 5.5 über die API 4,00 $ bzw. ca. 3,56 € pro 1 Million Input-Tokens berechnet, liegt der Bild-Input hier bei rund 0,0108 $ bzw. ca. 0,0096 € / knapp 1,0 Cent.) Bei älteren Modellen mit Standardauflösung würde Anthropic denselben Screenshot automatisch auf 1456×819 Pixel verkleinern – er würde dann etwa 1.560 Tokens belegen.
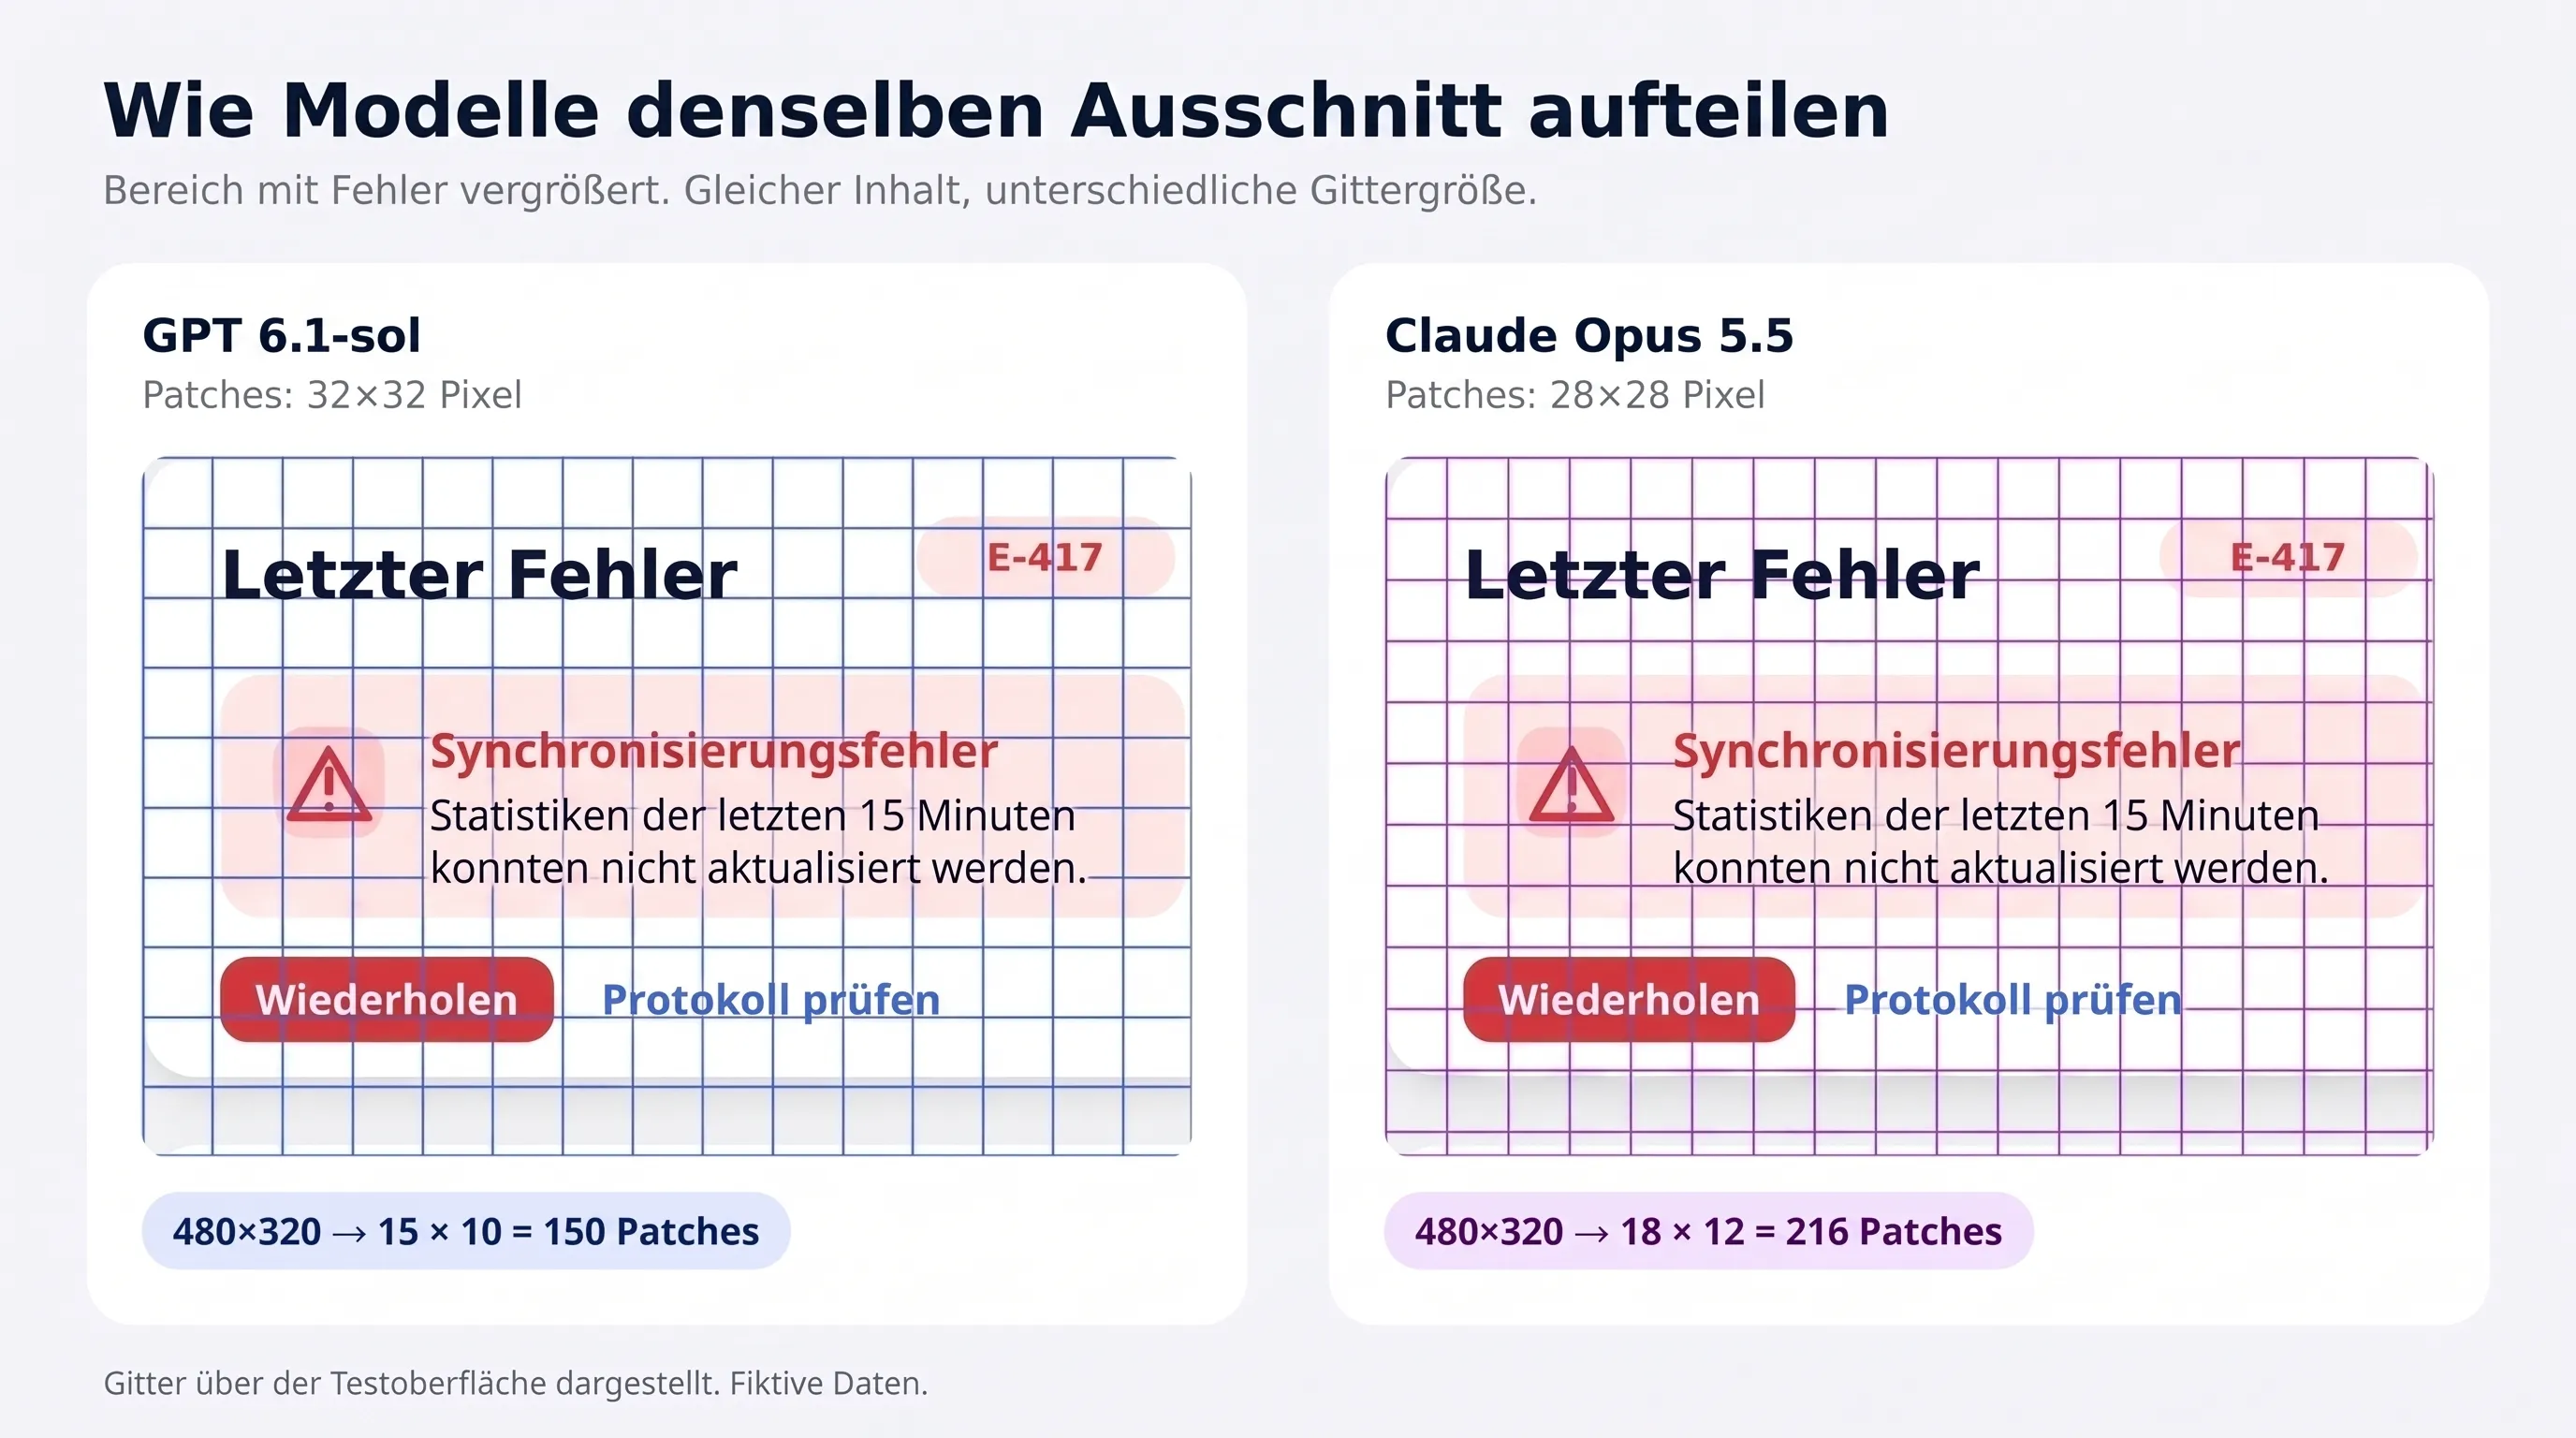 Visueller Vergleich: Unterschiedliche Kachelgrößen (Patches) bei OpenAI (32×32) und Anthropic (28×28).
Gemini 3.1 Pro Preview (Google): Dynamisches Budget via Media Resolution
Bei Gemini gibt es in der öffentlichen Kalkulation kein manuelles Patch-Raster. Stattdessen legt der Parameter media_resolution fest, wie viele Tokens das Modell einem Bild maximal zuweisen darf:
low— bis zu 280 Tokens;medium— bis zu 560 Tokens;high— bis zu 1.120 Tokens;ultra_high— bis zu 2.240 Tokens.
Google empfiehlt die Einstellung high für die meisten Bildanalyse-Aufgaben. Im Modus ultra_high setzt das Modell gewissermaßen die Lesebrille auf, um etwa winzige Schaltflächen auf dem Bildschirm zu finden. Genau so arbeiten beispielsweise KI-Agenten, die Softwareoberflächen anhand von Screenshots steuern (Computer Use).
Gemini reserviert für ein solches Bild bis zu 2.240 Tokens – also doppelt so viel wie im Modus high. Dieses volle Budget für ein simples Dialogfenster mit einer großen Fehlermeldung auszugeben, wäre jedoch reine Ressourcenverschwendung. Für PDF-Dokumente rät der Entwickler sogar dazu, mit medium zu starten, da höhere Auflösungen die OCR-Qualität bei Standarddokumenten kaum noch verbessern.
Für unseren Vergleich wählen wir high. Der Screenshot erhält damit ein Budget von bis zu 1.120 Tokens. (Beim offiziellen API-Preis für Gemini 3.1 Pro Preview von 2,00 $ bzw. ca. 1,78 € pro 1 Million Input-Tokens entspricht dies lediglich ca. 0,0022 $ bzw. rund 0,002 € / 0,2 Cent pro Screenshot.) Das exakte Gesamtvolumen einer Anfrage – also Bild inklusive Text-Prompt – lässt sich über die API-Methode countTokens abfragen.
Fassen wir die Ergebnisse in einer Übersichtstabelle zusammen:
| Modell | Modus | Berechnungsmethode | Ergebnis (Visuelle Tokens) | Reine API-Bildkosten (ca.) |
|---|---|---|---|---|
| GPT 6.1-sol | high oder original | Raster 32×32 Pixel | 2.040 Tokens | ~0,0041 $ (ca. 0,0036 €) |
| Claude Opus 5.5 | Erhöhte Auflösung | Raster 28×28 Pixel | 2.691 Tokens | ~0,0108 $ (ca. 0,0096 €) |
| Gemini 3.1 Pro Preview | media_resolution_high | Ungefähres Modus-Budget | bis zu 1.120 Tokens | ~0,0022 $ (ca. 0,002 €) |
Während GPT und Claude Breite und Höhe durch die jeweilige Patch-Größe teilen, aufrunden und miteinander multiplizieren, legt Gemini sein internes Raster nicht offen. Wir wählen lediglich den Auflösungsmodus, und Google gibt die Obergrenze des Token-Budgets an.
Wichtig zur Einordnung: Dies ist kein pauschales Ranking der Kosteneffizienz. Die Modelle unterscheiden sich sowohl bei den Token-Preisen als auch bei den Kontextlimits und der internen Bildverarbeitung. Aus unserer Rechnung lässt sich also nicht ableiten, dass Claude doppelt so viele Details erkennt und Gemini nur halb so viele. Wir haben lediglich verglichen, wie viele visuelle Input-Tokens die Anbieter für ein und denselben Screenshot veranschlagen.
Innerhalb desselben Modells macht der gewählte Modus hingegen einen erheblichen Unterschied – was wir auch bei der Konfiguration von Open WebUI (Einblickjetzt.de) für verschiedene Abteilungen berücksichtigen. Im Modus low skaliert der Dienst das Bild stark herunter, wodurch kleine Beschriftungen und Zahlen schlechter erkannt werden. In high oder original bleiben deutlich mehr Details erhalten. Wenn allerdings schon der Ausgangs-Screenshot unscharf oder stark verpixelt ist, kann auch der teuerste Auflösungsmodus keine Wunder bewirken.
Best Practices: So bereiten Mitarbeitende Screenshots optimal für die KI vor:
- Taskleiste, irrelevante Browser-Tabs und leere Randbereiche vorab entfernen;
- Überschriften oder Bereichsnamen im Bild belassen, damit das Modell den Kontext versteht;
- keine langen „Tapeten“ aus mehreren aneinandergehängten Bildschirmen erstellen;
- bei kleiner Schrift gezielt einen Modus mit hoher Detailstufe (
high/original) wählen; - Geldbeträge, Artikelnummern und Fehlercodes in der Antwort immer kurz mit dem Original abgleichen.
Um die Trefferquote weiter zu erhöhen, lassen sich im Chat auch zwei Bilder gleichzeitig anhängen: die Gesamtansicht des Bildschirms und ein vergrößerter Ausschnitt. Auf dem ersten Bild erkennt das Modell, in welchem Modul der Fehler aufgetreten ist, und auf dem zweiten kann es den Text gestochen scharf ablesen. Kurz gesagt: Einen Screenshot für die KI sollte man genauso sorgfältig vorbereiten wie für eine Kollegin oder einen Kollegen im Support.
Token-Ersparnis durch gezieltes Zuschneiden (Cropping)
Wir haben bereits empfohlen, überflüssige Browser-Tabs und die Taskleiste vor dem Upload abzuschneiden, damit das Modell nicht durch irrelevante Details abgelenkt wird. Rechnen wir nach, ob sich das auch finanziell bzw. beim Token-Verbrauch lohnt.
Schneiden wir aus unserem 1920×1080-Screenshot einen relevanten Bildausschnitt von 960×540 Pixeln heraus – wir behalten also nur den Bereich, auf den es wirklich ankommt:
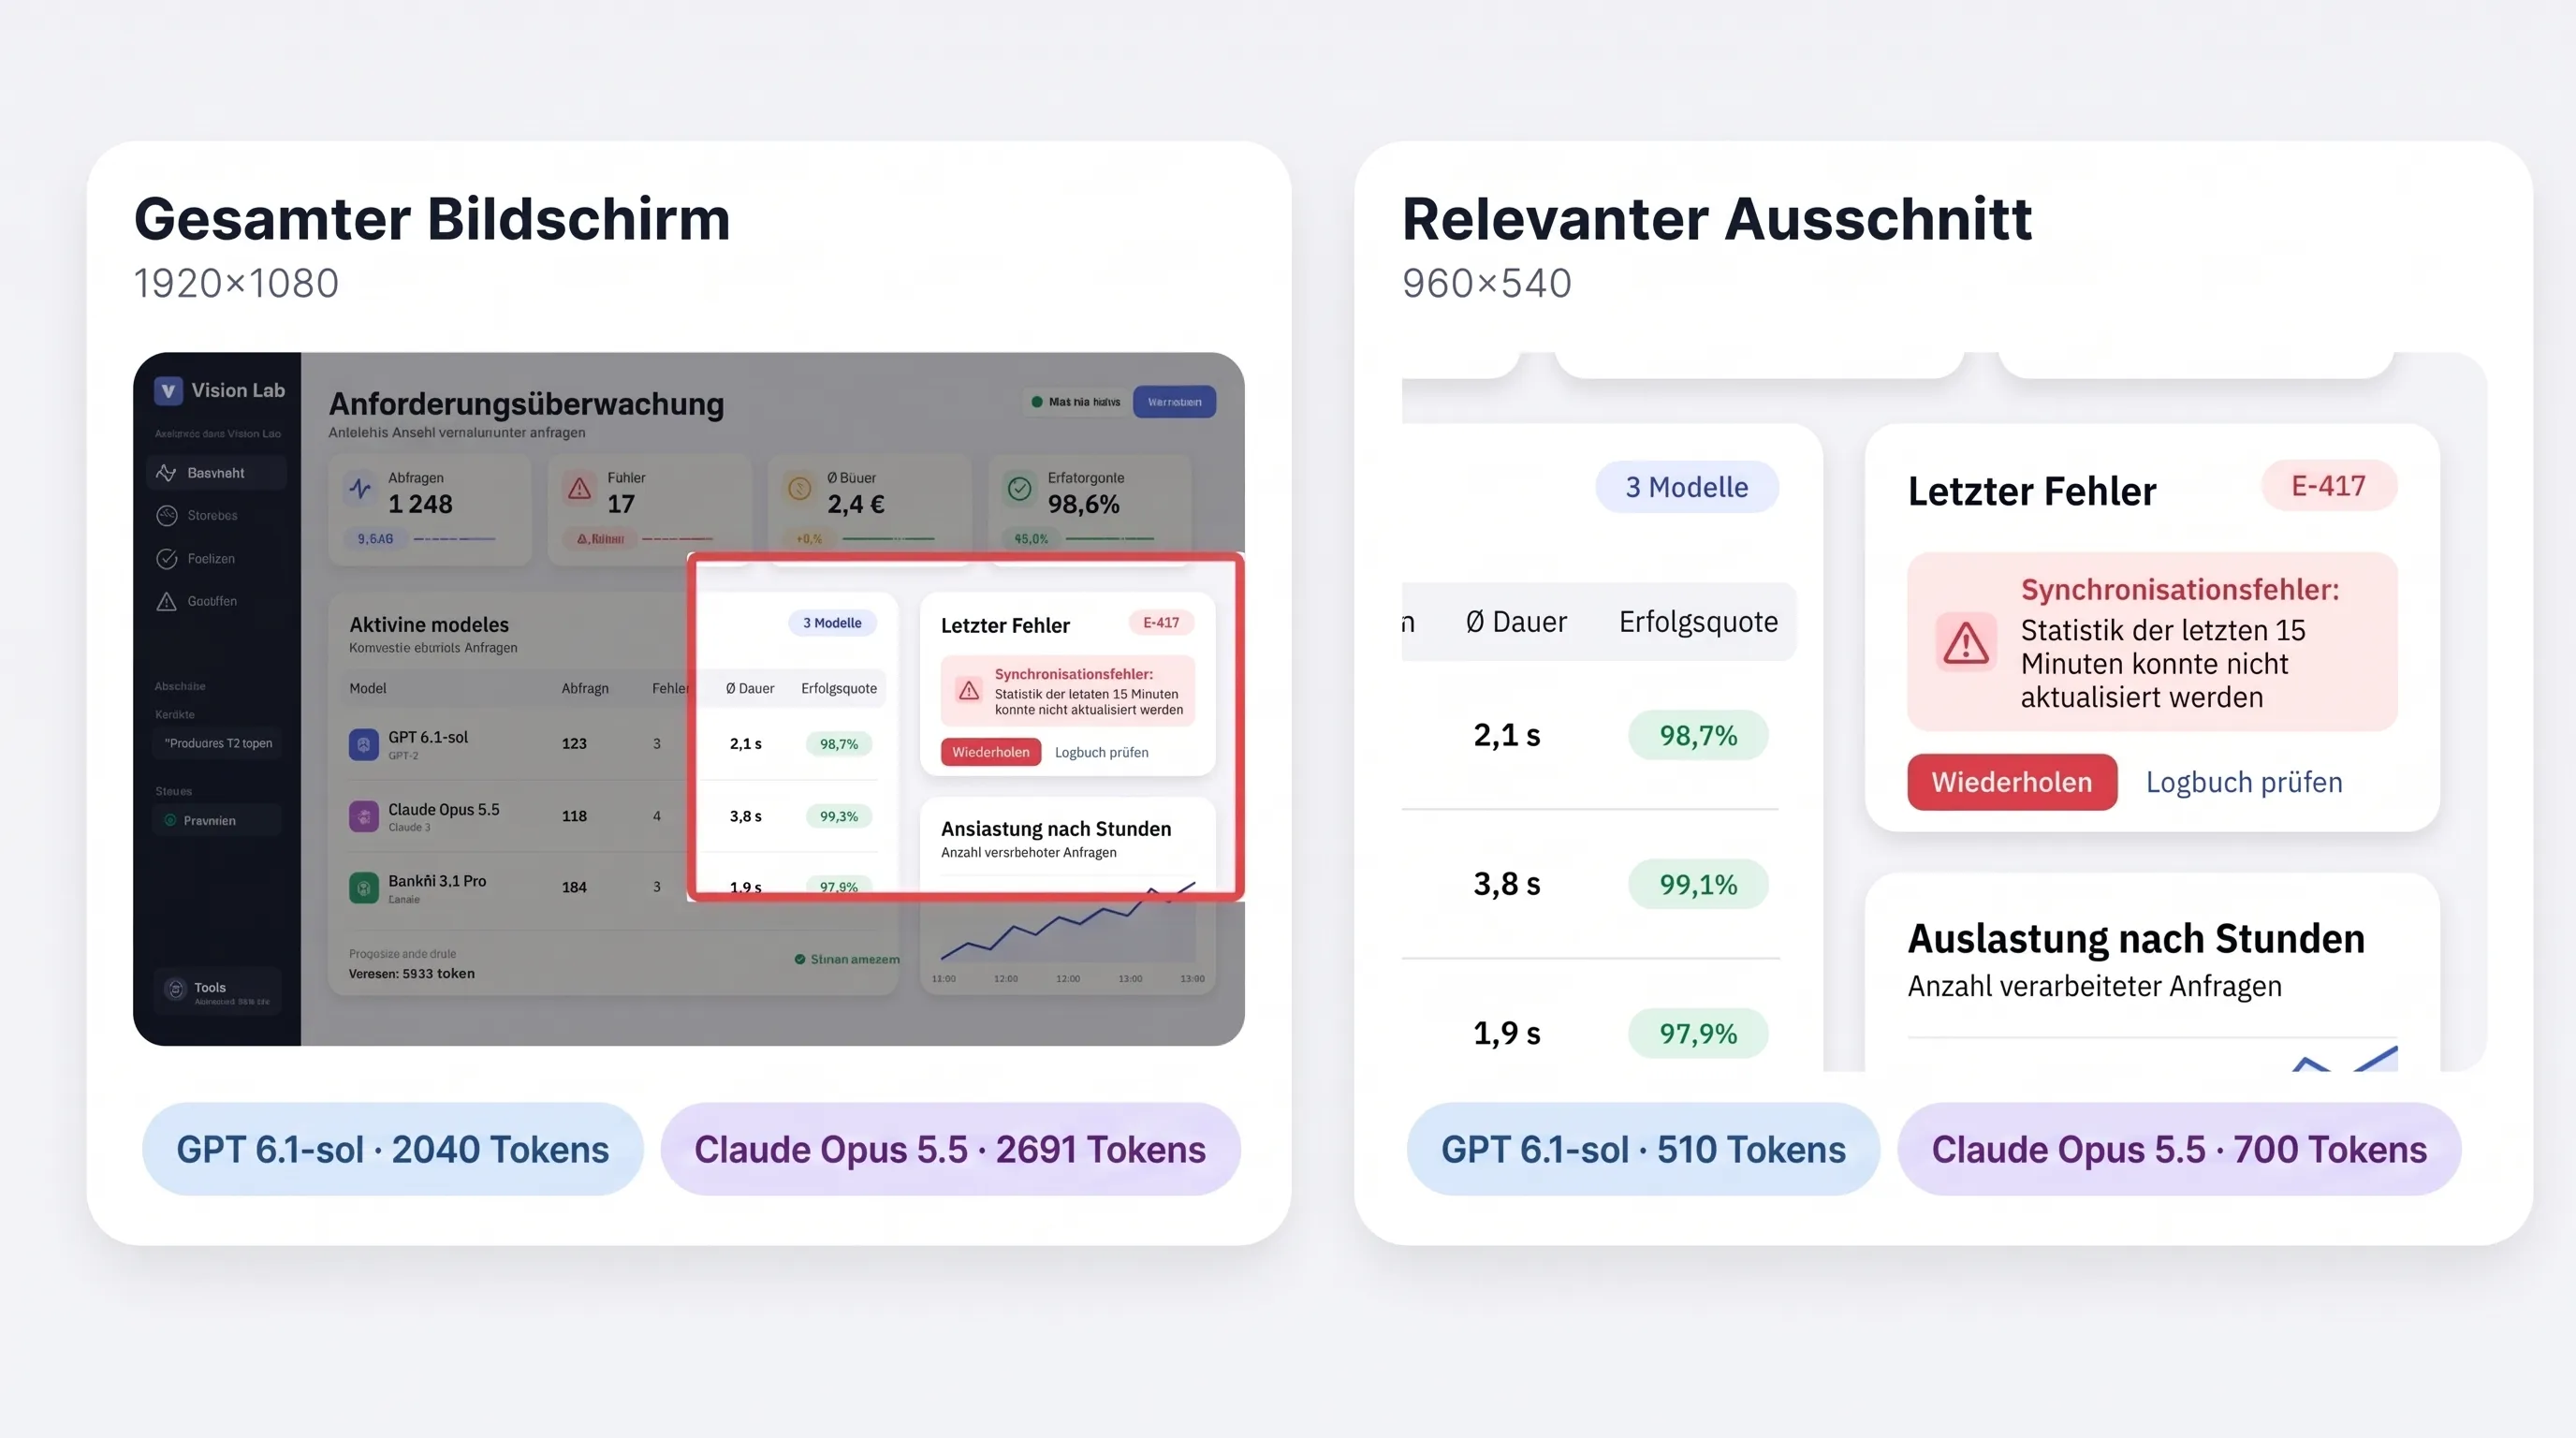 Gezielter Bildausschnitt (960×540 Pixel) ohne Menüs und leere Flächen.
Vorab ein wichtiger Unterschied: Wir setzen im Folgenden die neuen Abmessungen in die Formeln der Anbieter ein, weil wir das Bild zugeschnitten (gecroppt) und nicht einfach herunterskaliert haben. Beim Skalieren des gesamten Bildschirms würden auch Buchstaben und Buttons kleiner und schwerer lesbar. Durch das Zuschneiden bleibt die Originalgröße der Schrift zu 100 % erhalten, während irrelevante Bildschirmflächen gar nicht erst in die API-Anfrage gelangen.
Für GPT 6.1-sol verwendet OpenAI weiterhin das 32×32-Pixel-Raster:
ceil(960 / 32) × ceil(540 / 32) = 30 × 17 = 510
Wir erhalten 510 visuelle Tokens.
Claude Opus 5.5 rechnet mit Patches von 28×28 Pixeln:
ceil(960 / 28) × ceil(540 / 28) = 35 × 20 = 700
Hier kommen wir auf 700 visuelle Tokens.
Vergleichen wir das Ergebnis mit dem vollständigen Bildschirm:
| Modell | Vollbild 1920×1080 | Ausschnitt 960×540 | Ersparnis |
|---|---|---|---|
| GPT 6.1-sol | 2.040 Tokens | 510 Tokens | −75 % |
| Claude Opus 5.5 | 2.691 Tokens | 700 Tokens | −74 % |
Da wir sowohl die Breite als auch die Höhe halbiert haben, hat sich die Bildfläche geviertelt. Bei GPT sinkt der Token-Verbrauch exakt auf ein Viertel. Bei Claude fällt die Ersparnis minimal geringer aus, da unvollständige Patches an den Rändern jeweils voll aufgerundet werden.
Erkennt das Sprachmodell Details durch das Zuschneiden besser?
Allein an der Token-Anzahl lässt sich das nicht ablesen. Natürlich nimmt der relevante Text nach dem Zuschneiden einen deutlich größeren Anteil der Bildfläche ein. Allerdings kommt es stark auf den fachlichen Kontext an: Für die einfache Frage „Welcher Fehlercode steht im Dialogfenster?“ reicht der enge Bildausschnitt völlig aus. Fragt ein Mitarbeitender in Open WebUI jedoch, warum der Fehler aufgetreten ist und welche Schritte zur Behebung nötig sind, benötigt das Sprachmodell für eine fundierte Antwort oft die gesamte Programmoberfläche als Kontext.
In solchen Fällen empfiehlt sich die Kombination aus beiden Welten – also das Hochladen von zwei Bildern (Vollbild plus vergrößerter Ausschnitt). Nach unseren Formeln beträgt das Gesamtvolumen dann:
- GPT 6.1-sol: 2.040 + 510 = 2.550 Tokens
- Claude Opus 5.5: 2.691 + 700 = 3.391 Tokens
Auch das ist eine rechnerische Schätzung für den Bild-Input. Von einer Token-Ersparnis kann hier zwar keine Rede mehr sein – die Anfrage wird um rund ein Viertel größer –, dafür erhält das Modell aber sowohl den Gesamtzusammenhang als auch das perfekt lesbare Detail.
Die deutlich sparsamere Alternative für den Unternehmensalltag besteht darin, nur den zugeschnittenen Bildbereich hochzuladen und den fehlenden Kontext kurz in Textform im Prompt zu ergänzen, zum Beispiel:
Der Fehler ist im Bereich „Einstellungen → Synchronisierung“ aufgetreten. Lies den Fehlercode auf dem Screenshot aus und erkläre die mögliche Ursache.
Bei Gemini funktioniert die Mathematik anders: Dort lässt sich die Bildgröße nicht einfach durch eine Patch-Größe teilen, da Google über den Parameter media_resolution ein pauschales Token-Budget vorgibt.
Trotzdem ist das Zuschneiden auch bei Gemini sinnvoll – allein schon, weil der relevante Bereich dadurch das gesamte Bildfeld ausfüllt und im internen Budget höher aufgelöst verarbeitet wird, wenn auch ohne die vierfache Token-Ersparnis wie bei GPT oder Claude. Und noch ein technischer Hinweis: Zuschneiden (Cropping) und Komprimieren sind zwei völlig verschiedene Paar Schuhe. Eine stark komprimierte JPEG-Datei hat zwar weniger Kilobyte auf der Festplatte als ein PNG, doch solange die Pixelabmessungen (z. B. 1920×1080) gleich bleiben, ändert sich an der berechneten Anzahl der Patches überhaupt nichts. Eine zu starke JPEG-Komprimierung führt lediglich zu Artefakten und verwaschenen Buchstaben.
Fazit: Kosten- und Kontextkontrolle für Open WebUI im Unternehmen
Unterm Strich hat ein und derselbe Screenshot in den drei großen Modellen drei unterschiedliche „Gewichte“: 2.040 Tokens bei GPT 6.1-sol, 2.691 Tokens bei Claude Opus 5.5 und bis zu 1.120 Tokens bei Gemini 3.1 Pro Preview im Modus high. Diese Zahlen sagen nichts darüber aus, welches Modell im Einzelfall am genauesten liest – sie zeigen aber transparent, wie viel Platz ein Bild im jeweiligen Kontextfenster und API-Budget beansprucht.
Für die Budgetplanung im Unternehmen liefern diese Werte eine verlässliche Kalkulationsgrundlage. In der Praxis rechnet der API-Provider bei jeder Anfrage in Open WebUI natürlich noch den Text-Prompt (inklusive eventueller System-Prompts) sowie die generierte Textantwort des Modells hinzu.
Wenn Sie für Ihr Unternehmen genau wissen möchten, welche laufenden API-Kosten beim Einsatz von Dokumenten- und Screenshot-Analysen entstehen, empfehlen wir vor dem unternehmensweiten Rollout einen kurzen Praxistest: Lassen Sie rund 20 typische Arbeits-Screenshots aus Ihrem realen Tagesgeschäft über die Plattform verarbeiten, um den durchschnittlichen Verbrauch pro Anfrage exakt zu ermitteln. Mit Einblickjetzt.de unterstützen Sie die Teams von Finelbo und InnovaForge in partnerschaftlicher Kollaboration gerne dabei, Ihre eigene Open-WebUI-Plattform datenschutzkonform einzurichten, die passenden Modelle (von OpenAI über Anthropic bis Google Gemini) optimal anzubinden und die Parameter für Bildauflösung und Token-Verbrauch perfekt auf die Anforderungen Ihrer Teams abzustimmen. Nutzen Sie gerne unser Kontaktformular für ein unverbindliches Erstgespräch.
Häufige Fragen (FAQ)
Wie viele Tokens verbraucht ein Full-HD-Screenshot (1920×1080) bei GPT, Claude und Gemini?
Ein Full-HD-Screenshot mit 1920×1080 Pixeln verbraucht bei GPT 6.1-sol 2.040 visuelle Tokens (Raster aus 32×32 Pixeln) und bei Claude Opus 5.5 2.691 Tokens (Raster aus 28×28 Pixeln im High-Resolution-Tier). Google Gemini 3.1 Pro Preview arbeitet hingegen mit festen Stufenbudgets über den Parameter media_resolution: Im empfohlenen Modus high belegt das Bild maximal 1.120 Tokens, im Modus ultra_high bis zu 2.240 Tokens.
Spart Bildkomprimierung (z. B. JPEG statt PNG) Tokens bei multimodalen LLMs?
Nein. Die Dateigröße in Kilobyte oder Megabyte spielt für die Token-Berechnung der Modellanbieter keine Rolle. Entscheidend sind ausschließlich die Pixel-Abmessungen (Breite × Höhe) und die Kachelgröße des jeweiligen Modells. Eine stärkere JPEG-Komprimierung reduziert lediglich die Dateigröße beim Netzwerk-Upload, verringert aber den Token-Verbrauch um kein einziges Token und führt bei zu starker Kompression zu Lesefehlern bei kleiner Schrift.
Wie viel Prozent Tokens spart das Zuschneiden (Cropping) in der Praxis?
Das Zuschneiden auf den relevanten Bildausschnitt reduziert den Token-Verbrauch drastisch. Wird ein Screenshot von 1920×1080 auf 960×540 Pixel zugeschnitten, viertelt sich die Bildfläche (−75 %). Bei GPT 6.1-sol sinkt der Token-Verbrauch exakt um 75 % von 2.040 auf 510 Tokens, bei Claude Opus 5.5 um 74 % von 2.691 auf 700 Tokens. Gleichzeitig bleibt die Originalauflösung und Lesbarkeit der Schrift zu 100 % erhalten.
Welcher Auflösungsmodus empfiehlt sich für OCR und Textanalyse in Screenshots?
Für Benutzeroberflächen, Fehlermeldungen, Dashboards und tabellarische Daten empfiehlt sich bei OpenAI der Modus high oder original, bei Claude die reguläre High-Resolution-Stufe und bei Google Gemini mindestens high oder ultra_high. Niedrigere Modi wie low skalieren das Bild stark herunter (z. B. auf 512×512 Pixel), wodurch Ziffern, kleine Beschriftungen und UI-Details verschwimmen.
Wie können Unternehmen API-Kosten für Bild-Uploads in Open WebUI steuern?
Unternehmen können Bild-Token-Kosten durch rollenbasierte Quotas, das Vorschalten automatischer Preprocessing-Regeln (Entfernen von Taskleisten und leeren Bildrändern) sowie die gezielte Modellauswahl steuern. Im Rahmen unserer gemeinsamen Lösung Einblickjetzt.de (in enger Kooperation zwischen Finelbo und InnovaForge) konfigurieren wir Open WebUI mit granularen Berechtigungen, angepassten media_resolution-Parametern und dedizierten Modellen für unterschiedliche Fachabteilungen.